Видео с ютуба Qwen3.8 Flash Next

Qwen3.8-Flash-Next vs Qwen3.8-27B: Which Should You Run?

Qwen3.8-Flash-Next: 51 млрд параметров, которые не хотят быть на вашей видеокарте (полный разбор)

Qwen 3.8 Flash Next на AMD Strix Halo: галоген, N-граммы и бенчмарки
Qwen3.8 Flash Next Is INSANE – Testing the PREVIEW of Qwen 4!
Qwen3.8-Flash-Next: Модель 125B MoE превосходит Claude Opus 4.6 — Локально! 🤯

Strata – Q4 vs NVFP4 vs FP4-Local – Qwen3.8-Flash-Next
Запуск Qwen3.8-Flash-Next на 12 ГБ видеопамяти

Qwen3.8 Flash Next is INSANE — 125B params, 6B active, and it fixed its own bug in 10 seconds

Qwen3.8-Flash-Next + DeepSeek Harness: мой новый основной инструмент

Запуск 125B ИИ-моделей со Strata на 12 ГБ VRAM: Qwen3 8 Flash Next, прощай 27B

Qwen3.8-Flash-Next сжат до 58 ГБ: на 50% меньше экспертов, 98,7% производительности в кодинге!
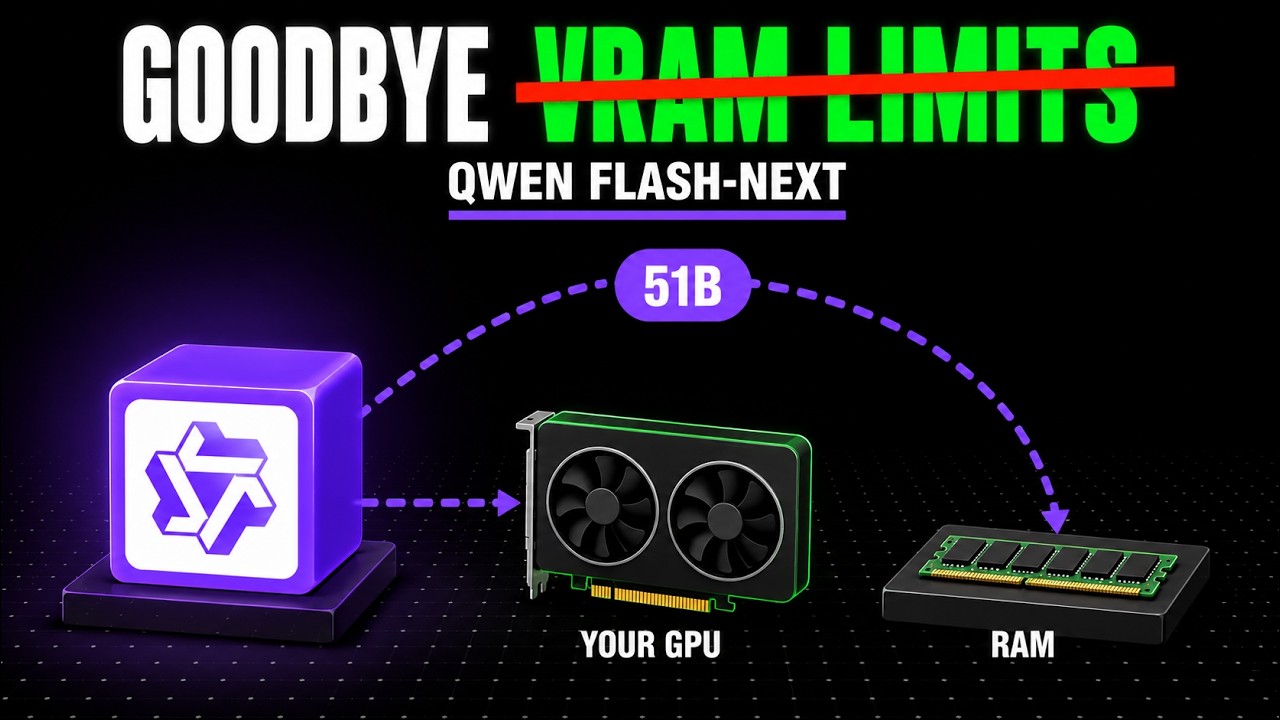
Qwen3.8-Flash-Next: The End of VRAM-Bottlenecked LLMs

Lean-QwenFlash: Qwen3.8-Flash-Next (модель 125B) на 8 ГБ оперативной памяти

Qwen3.8 Flash Next Runs Locally! 125B Model with RAM + SSD

Running Qwen 3.8 Flash Next on a $1000 Local AI Build with Strata

Qwen3.8-Flash-Next + MTPLX 2.10: БЕЗУМНО быстрые локальные ИИ-кодеры!
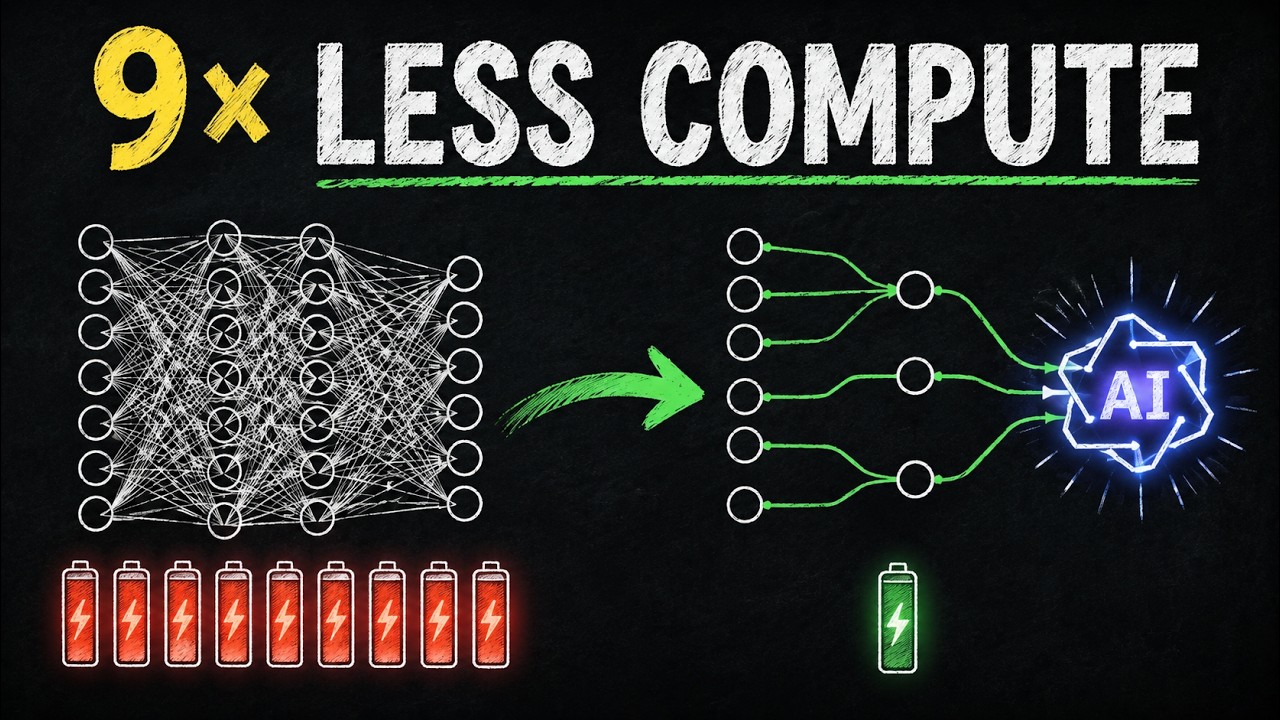
Qwen3.8-Flash-Next is Here: Inside Qwen4’s Insane New Engine
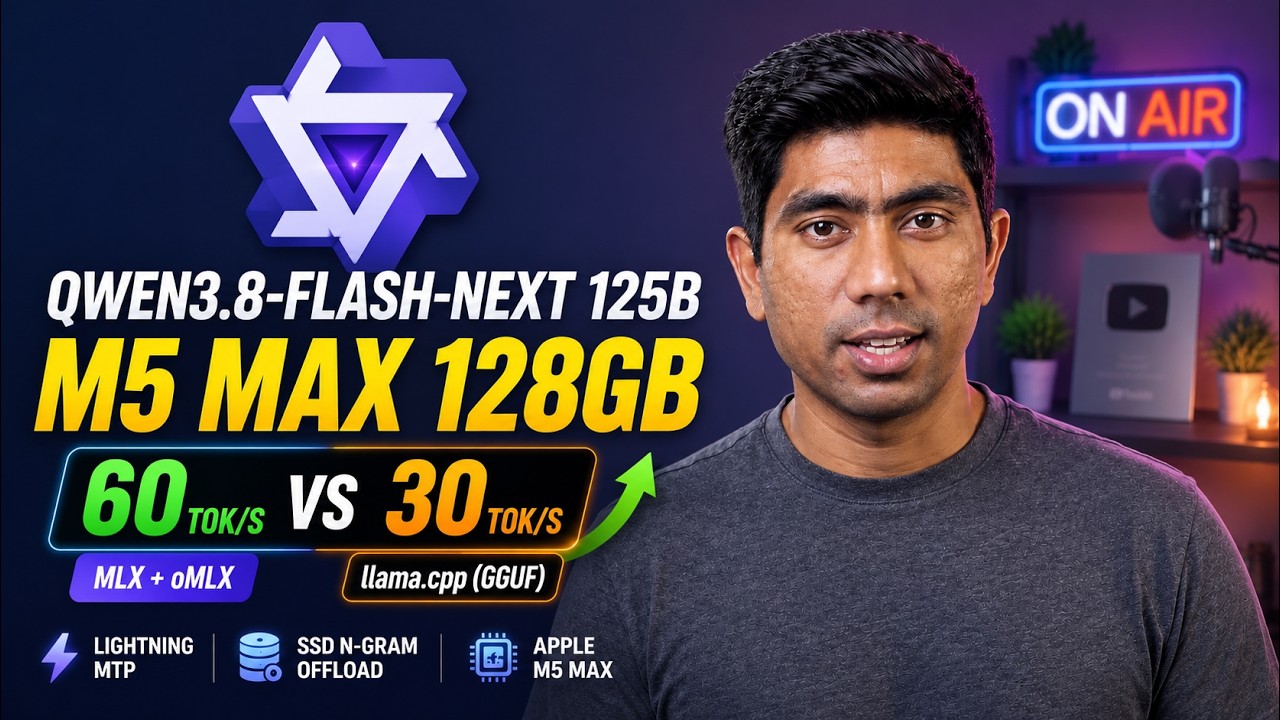
Qwen3.8-Flash-Next 125B: 60 токенов/с на MLX против 30 токенов/с на llama.cpp на M5 Max 🚀

Сравнение моделей Qwen3.8 27b и Qwen3.8 next flash 177b.

A Single Tesla P100 16GB Runs Qwen3.8 Flash Next at 30 Tokens/sec!